
Инструменты для SEO и семантики
То, что готовится до публикации страницы: собрать и почистить семантику, собрать служебные файлы, проверить длину заголовков и посмотреть, как страница будет выглядеть в выдаче.
17 инструментов в разделе
Группирует семантическое ядро по общим словам с учётом морфологии: один кластер ≈ одна посадочная. Быстрый черновик структуры сайта.
ОткрытьЛемматизация и нормализацияПриводит ключи к основе (стемминг) и схлопывает словоформы. Умный дедуп семантики: ловит дубли по падежам, числу и порядку слов.
ОткрытьЧистка по стоп-словамУдалить или оставить фразы со стоп-словами. Чистка семантического ядра от мусора.
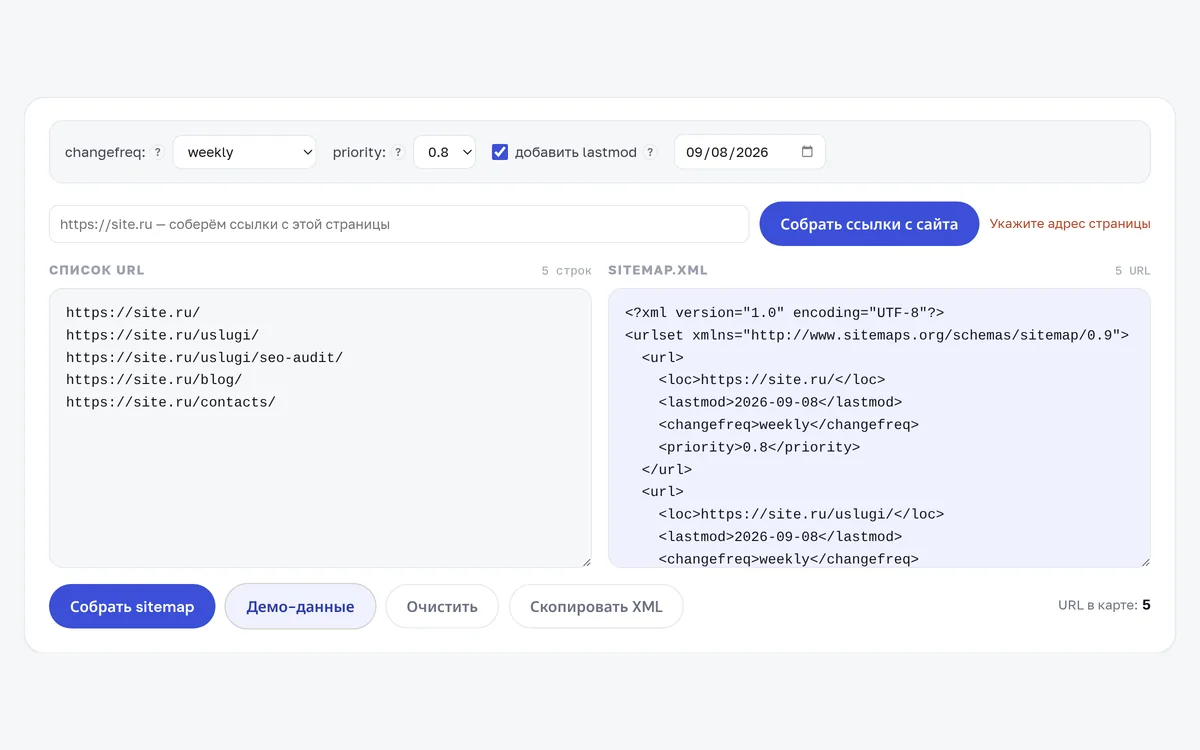
ОткрытьГенератор sitemap.xmlСоберёт ссылки прямо с вашего сайта по адресу или сделает карту из готового списка URL. lastmod, changefreq, priority.
ОткрытьГенератор 301-редиректовИз пар «старый → новый URL» собирает правила для nginx, Apache .htaccess или CSV. Для переезда сайта и смены ЧПУ без потери позиций.
ОткрытьГенератор robots.txtСобирает robots.txt: Disallow/Allow, Sitemap, Host, Crawl-delay. Пресеты «открыть/закрыть сайт» и «закрыть служебное CMS».
Открытьrobots.txt для AI + llms.txtГалочками закрываете или открываете нейросетевые боты (GPTBot, ClaudeBot, Google-Extended, PerplexityBot) и собираете модный файл llms.txt. На волне GEO.
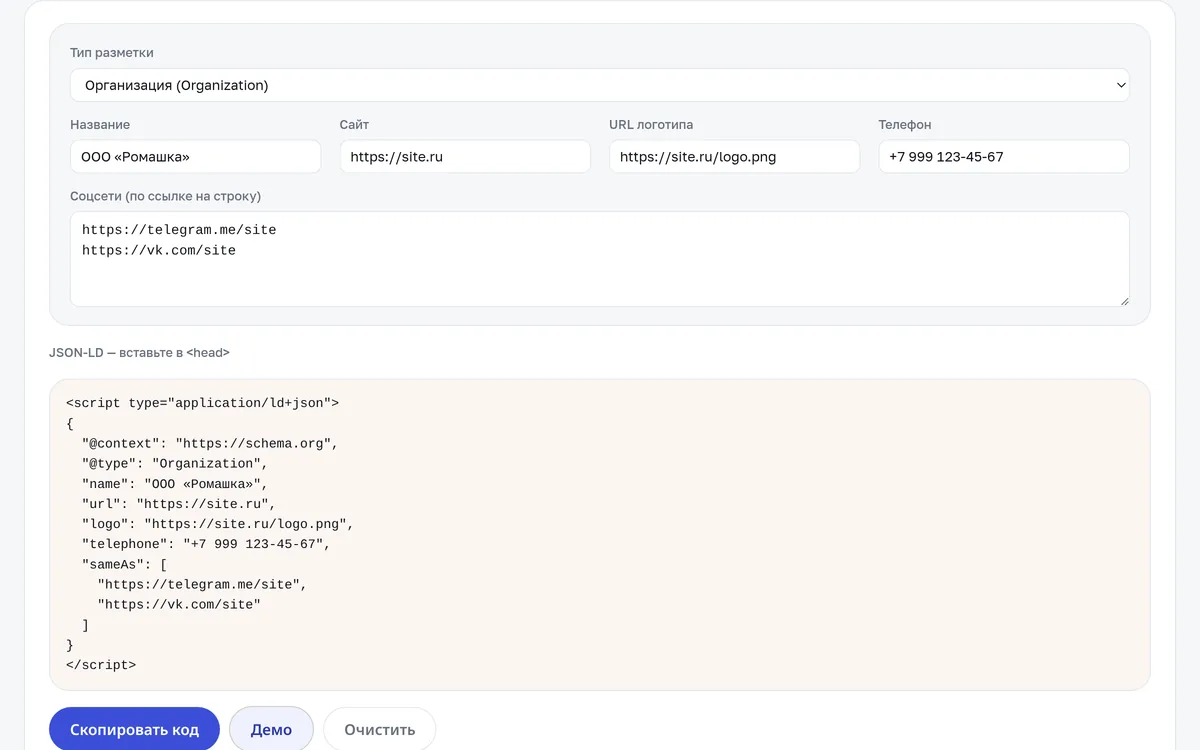
ОткрытьМикроразметка Schema.orgГенератор JSON-LD: Organization, LocalBusiness, Article, FAQ, хлебные крошки, Product. Готовый код для расширенных сниппетов и ИИ-выдач.
ОткрытьТранслитерация в URLПереводит русские заголовки в чистые URL-слаги (ЧПУ): транслит, дефисы, нижний регистр, удаление стоп-слов. Готовый slug для страницы.
ОткрытьКонструктор поискового запросаСобирает запрос с операторами site, title, filetype и минус-словами. Отдельный синтаксис для Яндекса и Google плюс шпаргалка.
ОткрытьTitle/Description: превьюПредпросмотр сниппета в выдаче и длина Title/Description в пикселях — видно, где Яндекс и Google обрежут заголовок.
ОткрытьДлина Title и DescriptionМассовая проверка длины метатегов списком: считает символы, помечает превышение лимита и подсвечивает хвост, который обрежется в выдаче.
ОткрытьСтоимость SEO для вашего проектаОриентир по бюджету и срокам под ваш тип бизнеса, размер сайта, конкуренцию и регион. Формула на 11 годах работы — за 2 минуты.
ОткрытьГенератор Open GraphГотовые og-теги и Twitter Card для страницы. С предпросмотром карточки, проверкой длин и подсказками по размеру картинки.
ОткрытьPunycode конвертерКириллический домен в запись xn-- и обратно. Полные адреса и списки, проверка предела в 63 знака на метку.
ОткрытьДерево сайтаСтруктура из списка адресов или sitemap.xml: разделы с числом страниц, глубина вложенности и разделы без собственной страницы.
ОткрытьПрогноз трафика по позициямКривая CTR × частотность: переходы сейчас, при выходе в топ-3 и топ-1, редактируемая кривая и поправка на Вордстат.
ОткрытьКакие задачи закрывает раздел
- 1Сбор и чистка ядра
Работа с ядром начинается с кластеризации запросов, а чистится оно удалением неявных дублей — фразы с одинаковым составом слов схлопываются даже при разном порядке и окончаниях. Мусорные запросы убирает фильтр по стоп-словам.
- 2Служебные файлы
Служебные файлы собираются генераторами: sitemap.xml с обходом сайта, robots.txt, 301-редиректы блоком для nginx или .htaccess и llms.txt для нейросетевых краулеров.
- 3Разметка и сниппет
Разметка страницы — это генератор Schema.org с готовыми типами и превью сниппета, где видно, где именно Яндекс и Google обрежут заголовок. Лимиты по символам показывает проверка длины Title и Description.
- 4Адреса и бюджет
Адреса страниц делает транслитерация в URL, сложные поисковые запросы для ручного анализа выдачи собирает конструктор операторов, а прикинуть бюджет помогает калькулятор стоимости SEO. Прогноз трафика по позициям умножает частотность на кривую CTR и показывает, что даст выход в топ.
Частые вопросы
С чего начать сбор семантики?
Чем неявные дубли отличаются от обычных?
Обязательно ли делать llms.txt?
Инструменты заменяют платные сервисы?
Другие группы каталога
Весь каталог собран в 10 групп. Вся витрина.
 Документы и финансы159
 Дом, ремонт и авто143
 Учёба и расчёты92
 Текст и картинки82
 Разработка и данные81
 Здоровье и спорт66
 Устройства и утилиты38
 Работа и поездки32
 Развлечения и случайность100
Подборки инструментов
Те же инструменты, собранные по типу расчёта и по работе: сначала пять наборов по типу, дальше восемь по профессии. Все наборы.