 Паветта
Латиница в кириллице и невидимые символы
Текст выглядит обычно, а поиск по нему промахивается: внутри слова стоит латинская «о» или неразрывный пробел из Word. Инструмент проходит текст посимвольно, подсвечивает подозрительные места прямо в тексте и выписывает каждое в таблицу — с позицией, кодом вида U+00A0 и объяснением, чем оно мешает.
Где стоят находки
Что нашлось
| Чинить | Позиция | Символ | Код | Что это | Чем мешает | Замена |
|---|---|---|---|---|---|---|
| Находок пока нет. | ||||||
Исправленный текст
Что находит проверка
Инструмент проходит текст посимвольно и находит то, что глазом не видно: латинские буквы внутри русских слов, русские внутри латинских, неразрывные пробелы из Word, мягкие переносы, символы нулевой ширины и другие невидимые знаки. Каждая находка подсвечивается прямо в тексте и попадает в таблицу с позицией, кодом и названием, а исправленный вариант с заменой на правильные буквы готов к копированию.
Русская «о» и латинская «o» выглядят одинаково, но для поиска, сортировки и ключевых слов это разные символы: страница с латинской буквой в слове не найдётся по запросу, формула в таблице не сойдётся. Такие подмены появляются при копировании из PDF и после автозамены.
| Находка | Как выглядит | Чем вредна |
|---|---|---|
| Латинская буква в русском слове | кoмпания (o — U+006F) | Поиск и проверка орфографии не узнают слово |
| Неразрывный пробел | U+00A0 | Строки не переносятся, дубли в базах |
| Мягкий перенос | U+00AD | Невидим, ломает поиск и сравнение |
| Символ нулевой ширины | U+200B | «Пустой» символ внутри слова |
| Русская буква в коде или URL | са.ru (с — U+0441) | Ссылка ведёт не туда |
История похожих букв
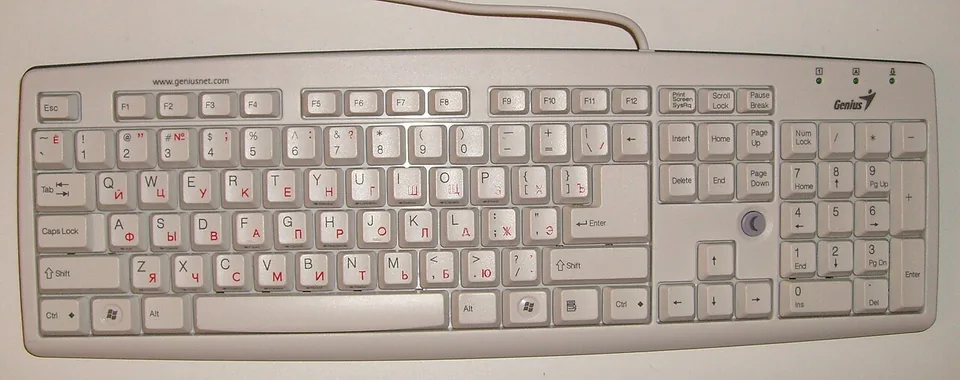
Подмена похожих букв старше компьютеров: наборщики путали кегли разных гарнитур, а в кириллице и латинице с XVIII века, после петровского гражданского шрифта, начертания а, е, о, р, с, у, х совпали. В Unicode 1991 года эти буквы получили разные коды, и компьютер стал различать то, что человек не видит.
В 2001 году Евгений Габрилович и Алекс Гонтмахер показали атаку омографов: домен с русской «а» вместо латинской выглядит как настоящий и ведёт на подделку; браузеры с тех пор показывают такие адреса в виде punycode. Консорциум Unicode ведёт список «confusables» из тысяч похожих пар, а невидимые символы, неразрывный пробел и мягкий перенос, приходят из Word и вёрстки. Инструмент проверяет текст по этим спискам.

Как проверять тексты
Вставьте текст и нажмите «Проверить»: подозрительные места подсветятся, таблица покажет каждый символ с кодом. Включите метки, чтобы увидеть невидимые символы, и скопируйте исправленный текст, где латиница внутри русских слов заменена на кириллицу и наоборот. Аббревиатуры вроде IT или URL инструмент не трогает: там латиница целиком.
Проверяйте так тексты для сайта перед публикацией и ключевые слова перед загрузкой в рекламу: одна латинская буква делает запрос невидимым. Кодировочные повреждения, где вместо букв мусор, лечит инструмент исправления кракозябр, а полную чистку от невидимых символов и лишних пробелов делает очистка текста.
| Проверка | посимвольная |
| Находит | подмены букв, невидимые символы |
| Показывает | позицию, код, название |
| Исправляет | да |
| Гражданский шрифт | 1708 |
| Unicode | 1991 |
| Атака омографов | 2001 |
| Данные на сервер | не уходят |
Как пользоваться
Исправление здесь выборочное: у каждой находки своя галочка, потому что неразрывный пробел перед «₽» и длинное тире в предложении часто стоят по делу. Разбор идёт в браузере, текст никуда не отправляется.
- Заголовок, описание товара, кусок статьи или строку из выгрузки. Разбор запускается сразу при вставке, потолок — 100 000 знаков за раз.
- Смешанные слова, невидимки и двойники пунктуации закрашены разным цветом прямо в тексте. Переключатель «показать спрятанные символы» рисует метки вместо пустоты, чтобы находки было видно глазами.
- Каждая строка — позиция, сам символ, его код, название по-русски и объяснение, чем он мешает. Клик по подсветке в тексте отмечает нужную строку.
- Галочки заранее стоят у явного мусора: буквы-двойники и символы нулевой ширины. Неразрывные пробелы, тире и ёлочки отмечайте вручную — часть из них поставлена осознанно.
- Исправленный текст собирается под таблицей и обновляется на каждую галочку. Кнопка кладёт его в буфер обмена.
Частые вопросы
Почему поиск не находит слово, которое видно на экране?
Скорее всего внутри слова стоит буква из другого алфавита. Латинские «a», «c», «e», «o», «p», «x», «y» и прописные «A», «B», «C», «E», «H», «K», «M», «O», «P», «T», «X» рисуются так же, как кириллические, но для компьютера это другие символы. Слово «оптовые» с латинской «о» никогда не совпадёт с запросом, набранным кириллицей. Тот же эффект дают символы нулевой ширины: они рвут слово посередине и остаются невидимыми.
Откуда такие символы берутся в тексте?
Чаще всего из копирования. Word и Google Docs сами ставят неразрывные пробелы и типографские кавычки, PDF отдаёт тонкие шпации вместо пробелов, вёрстка в макете добавляет мягкие переносы, часть CMS вставляет символ нулевой ширины при переносе строки. Буквы-двойники приходят из раскладки и из чужих выгрузок: латинская «C» в артикуле, кириллическая «О» в английском названии.
Неразрывные пробелы нужно вычищать?
Далеко не всегда. Неразрывный пробел держит на одной строке инициалы и фамилию, число и единицу измерения, короткий предлог и следующее слово — там он поставлен по делу. Убирать его стоит, когда текст едет в код, в адрес страницы, в CSV или в поле, где ждут обычный пробел. Поэтому у каждой строки таблицы своя галочка, и у пробелов она снята заранее.
Чем латинская буква в русском слове вредит сайту?
Поисковая система разбирает такое слово как другую последовательность символов и перестаёт связывать его с обычным запросом. Страница теряется по своему же названию, фильтр в каталоге не собирает товар в нужную группу, выгрузка в маркетплейс отдаёт дубль карточки. В заголовке и в адресе страницы это заметно сильнее всего: адрес выглядит привычно, а ведёт в никуда.
Что будет со словами вроде «SEOшник» или «Яndex»?
Они попадут в таблицу как смешанные: два алфавита в одном слове инструмент видит именно так. Замену для них он не предлагает — у латинских «S», «n», «d» кириллических двойников нет, и подстановка испортила бы слово. Галочка у такой строки не ставится: находку видно, решение остаётся за вами.
Чего инструмент не делает?
Он не проверяет орфографию и пунктуацию, не переключает раскладку и не трогает буквы из третьих алфавитов: греческая «ο» или сербская «ј» внутри русского слова здесь проходят мимо проверки. Разбор ограничен парой кириллица-латиница, цифрой ноль и списком служебных символов из таблицы. Отличить осмысленный неразрывный пробел от случайного он тоже не берётся, это решение за вами.
Текст уходит на сервер?
Нет. Разбор, подсветка и правка считаются в вашем браузере на этой же странице, сетевых запросов инструмент не делает. Черновики и внутренние документы можно вставлять спокойно: они остаются на вашем компьютере.
Сколько текста он потянет?
За раз разбирается до 100 000 знаков — около полусотни машинописных страниц. Подсветка рисуется для первых 20 000 знаков, чтобы вкладка не подтормаживала на слабом ноутбуке, таблица показывает первые 400 находок. Исправление при этом применяется ко всему тексту, включая находки, которые в таблицу не поместились.
Спросите нейросети об инструменте
Больше возможностей: Нейросеть для текста, написать, сократить, переписать.
Похожие инструменты
Вставьте испорченный текст — инструмент сам переберёт кодировки и покажет несколько расшифровок, начиная с самой похожей на русскую. Файлы тоже чинит.
ОткрытьОчистить текстУбирает невидимые символы, лишние пробелы и пустые строки, эмодзи, выравнивает кавычки и тире; показывает, что и сколько удалено.
ОткрытьДни недели и месяцы на английскомДни недели и месяцы на английском с транскрипцией, сокращениями и происхождением названий, календарь по-английски и запись даты в британском и американском формате.
ОткрытьКорейский алфавит хангыльБуквы хангыля с русским чтением, сборка слогов из букв, транскрипция корейского текста по Концевичу и латиницей.
ОткрытьСимволы для копированияСимволы для копирования в один клик: галочка, сердечко, стрелки, градус, бесконечность, звёзды, валюты, кавычки. Как набрать каждый: Alt-код, Word и Mac.
ОткрытьКак называется боязньСловарь фобий: как называется боязнь высоты, пауков, людей, темноты, крови, длинных слов. Поиск по страху и по термину, корни названий.
ОткрытьЕщё инструменты для текста
Проверка орфографии, анализ на воду и тошноту, счётчик символов, сравнение двух текстов, типографор, регистр и замены — в разделе 46 инструментов.