 Паветта
Исправить кракозябры: автоподбор кодировки
Текст превратился ⠫привет» или в «Ð Ñ», и непонятно, где он сломался. Инструмент перебирает правдоподобные цепочки порчи — UTF-8, прочитанный как windows-1251, KOI8-R или IBM866, двойную перекодировку, HTML-мнемоники, процентные коды — и показывает несколько расшифровок сразу.
Файл в неизвестной кодировке
Как подбирается кодировка
Инструмент восстанавливает текст, превратившийся ⠫привет» или «Ð Ñ»: перебирает правдоподобные цепочки порчи, UTF-8, прочитанный как windows-1251, KOI8-R или IBM866, двойную перекодировку, HTML-мнемоники и процентные коды, и показывает несколько вариантов расшифровки с оценкой, насколько результат похож на русский текст. Файл в неизвестной кодировке можно прочитать целиком и скачать перекодированным.
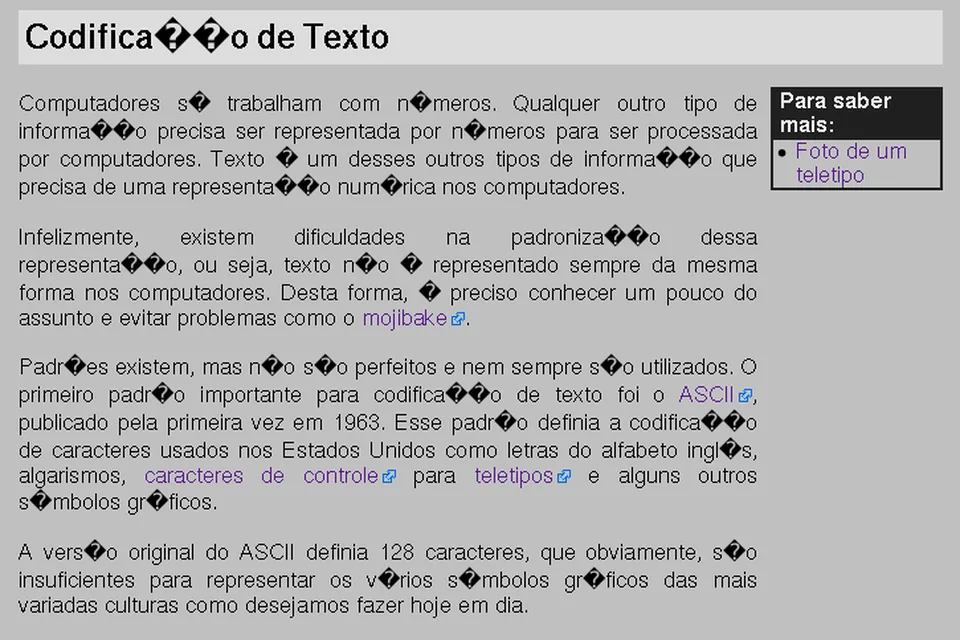
Кракозябры — это всегда пара кодировок: одна записала байты, другая их прочитала. «РїСЂРёРІРµС‚» — UTF-8, прочитанный как windows-1251, «ЏђЋ‚…‘’» — та же пара наоборот, а знаки вопроса в ромбах означают, что байты уже потеряны и восстановить их нельзя.
| Как выглядит | Что случилось | Лечится ли |
|---|---|---|
| привет | UTF-8 прочитали как windows-1251 | да |
| привет | UTF-8 прочитали как latin-1 | да |
| ЮПХБЕР | KOI8-R прочитали как windows-1251 | да |
| пр | HTML-мнемоники вместо букв | да |
| ?????? или ������ | Байты заменены при сохранении | нет |
История русских кодировок
У русского текста в компьютере было пять несовместимых кодировок: КОИ-8 из ГОСТа 1974 года, где буквы стояли так, чтобы при потере старшего бита текст читался латиницей, CP866 для DOS, windows-1251 для Windows 1990-х, ISO 8859-5 и «маковская» кодировка. Один и тот же байт означал разные буквы, и письмо из одной системы в другой превращалось в мусор; это и назвали кракозябрами.
Кен Томпсон и Роб Пайк в 1992 году придумали UTF-8, где кириллица занимает два байта, и к 2008 году эта кодировка обогнала все остальные в интернете, а сегодня в ней больше 98 % страниц. Но старые файлы, письма и базы данных остались, и порча возникает при каждом переносе между системами. Инструмент перебирает известные пары и находит ту, что возвращает русский текст.


Как восстановить текст
Вставьте испорченный текст: инструмент сам подберёт цепочку и покажет варианты, лучший сверху; выберите тот, где текст читается, и скопируйте. Для файла укажите, в какой кодировке его читать, и скачайте перекодированную копию. Чем длиннее фрагмент, тем точнее подбор: по двум словам кодировку не отличить.
Если во всех вариантах остаются ромбы или вопросы, байты потеряны, и поможет только исходный файл. Латинские буквы, похожие на русские, и невидимые символы ищет проверка латиницы в кириллице, а коды любого символа показывает таблица символов Unicode.
| Кодировки | UTF-8, 1251, KOI8-R, 866, latin-1 |
| Цепочки | в том числе двойные |
| Файлы | чтение и скачивание |
| Не лечится | ромбы и вопросы |
| КОИ-8 | ГОСТ 1974 |
| UTF-8 | 1992 |
| Доля UTF-8 в вебе | больше 98 % |
| Данные на сервер | не уходят |
Как пользоваться
Порядок задаёт оценка: доля кириллицы, доля пробелов и частота русских буквенных пар. Рядом видно, что именно определилось: исходная кодировка, во что её ошибочно прочитали, сколько символов и русских букв получилось на выходе. Файл .csv, .txt или .sql переводится в UTF-8; для русского Excel есть обратная выгрузка в windows-1251 и в UTF-8 с BOM.
- Хватит одного абзаца: подбор идёт по буквенной статистике, и длина текста мало что добавляет. Разбор запускается сразу при вставке.
- Наверх встаёт та расшифровка, которая больше похожа на русский язык. Остальные варианты лежат рядом и переключаются одной кнопкой.
- В карточках рядом с результатом видно исходную кодировку, во что её прочитали, сколько символов получилось и сколько русских букв восстановилось.
- Кнопка копирования кладёт результат в буфер. Рядом — выгрузка файлом в UTF-8, в UTF-8 с BOM или в windows-1251.
- Загрузите .csv, .txt или .sql: кодировка определится по содержимому, и скачается уже перекодированный файл с тем же содержимым.
Частые вопросы
Почему русский текст превращается ⠫привет»?
Буква в UTF-8 занимает два байта. Если программа читает эти байты по одному и считает, что перед ней windows-1251, каждая русская буква распадается на два непохожих символа. Обратная операция возвращает исходные байты и читает их уже как UTF-8. Именно эту цепочку инструмент проверяет первой.
Чем «РїСЂРёРІ» отличается от «Ð рив»?
Это одна и та же порча, прочитанная разными таблицами. Первый вид даёт windows-1251 — русская кодировка, поэтому мусор выглядит кириллицей. Второй даёт windows-1252 (она же Latin-1), которой пользуются западные системы, поэтому там вылезает латиница с диакритикой. Инструмент различает эти случаи по тому, какие символы вообще существуют в каждой таблице.
В тексте стоят ромбики «▬» или «�». Их можно вернуть?
Дословно вернуть их нельзя. Такой символ означает, что программа уже прочитала байт, не смогла его разобрать и записала вместо него заглушку — исходное значение байта при этом стёрлось. Инструмент считает, сколько таких мест в тексте, и показывает это отдельной строкой. Помогает только исходный файл до перекодировки.
Текст уходит на сервер?
Нет. Весь разбор идёт в вашем браузере: таблицы кодировок зашиты в страницу, сетевые запросы инструмент не делает. Файл, который вы выбираете, тоже читается локально и никуда не отправляется.
Почему Excel ломает мой CSV с русскими буквами?
Русская версия Excel по умолчанию открывает CSV в windows-1251 и не пытается распознать UTF-8. Есть два рабочих выхода: сохранить файл прямо в windows-1251 или оставить UTF-8, добавив в начало метку BOM — три байта EF BB BF, по которым Excel понимает кодировку. Обе выгрузки есть в блоке скачивания.
Какие кодировки инструмент знает?
UTF-8, UTF-16 с меткой BOM, windows-1251, windows-1252, KOI8-R и IBM866, плюс HTML-мнемоники вида П и процентные коды вида %D0%9F. Азиатских кодировок, ISO-8859-5, UTF-7 и cp1250 здесь нет — они дают другой рисунок мусора и требуют своих таблиц.
Насколько большой текст и файл он потянет?
Текстовое поле разбирает до 100 000 символов за раз, файл — до 4 МБ. Ограничения стоят затем, чтобы вкладка не зависла на слабом ноутбуке или телефоне: перебор гоняет каждую цепочку по всей строке. Файл побольше имеет смысл резать на части.
Всегда ли верхний вариант правильный?
На связном тексте от пары слов — почти всегда. На коротких обрывках вроде одного слова из трёх букв статистика шаткая, и соседний вариант может оказаться ближе к правде. Поэтому рядом с победившей расшифровкой показаны и остальные, вместе с оценкой похожести у каждой.
Спросите нейросети об инструменте
Похожие инструменты
Находит латинские буквы внутри русских слов и спрятанные символы: неразрывные пробелы, нулевую ширину, мягкий перенос. Правит выборочно: трогает только эти символы.
ОткрытьИнспектор UnicodeКод каждого символа U+XXXX, десятичный номер, байты UTF-8 и UTF-16, HTML-сущность, поиск невидимых и составных символов в тексте.
ОткрытьГлаголица: алфавит и переводчикВсе буквы глаголицы с названиями, кириллическими соответствиями и числовыми значениями, перевод текста на глаголицу и обратно.
ОткрытьГенератор хештеговХештеги по теме и городу для Instagram, TikTok, ВК и YouTube с лимитом площадки и фильтром спамных тегов.
ОткрытьАнаграммыАнаграммы слова, фразы и имени из одного, двух и трёх слов с анимацией перестановки букв.
ОткрытьПеревернуть текстТекст задом наперёд, слова в обратном порядке и вверх ногами через Unicode: для ников, постов и шуток, с копированием одной кнопкой.
ОткрытьЕщё инструменты для текста
Проверка орфографии, анализ на воду и тошноту, счётчик символов, сравнение двух текстов, типографор, регистр и замены — в разделе 46 инструментов.