 Паветта
Инспектор Unicode
Два одинаковых на вид слова могут различаться: латинская «с» вместо кириллической, неразрывный пробел вместо обычного, символ нулевой ширины, вставленный при копировании.
По символам
Что показывает инспектор про каждый символ
Инспектор разбирает текст посимвольно и для каждого знака показывает код U+XXXX, десятичный номер, байты UTF-8, кодовые единицы UTF-16, HTML-сущность и группу — кириллица, латиница, цифра, пробел, эмодзи. Невидимые и подозрительные знаки он подсвечивает и считает. Нужен, когда пароль «не подходит», поиск по странице «не находит» очевидное слово, строка в базе не совпадает с такой же на вид или из скопированного текста лезут лишние пробелы.
Кодовая точка — это номер символа в Unicode, записанный шестнадцатеричным числом с приставкой U+: буква «я» — U+044F, то есть 1103. В UTF-8 она занимает два байта D1 8F, в UTF-16 — одну единицу. Пространство кодов доходит до U+10FFFF, знаки выше U+FFFF в UTF-16 записываются суррогатной парой, и поэтому JavaScript считает такой символ за два. Эмодзи-флаги, семьи и тона кожи собираются из нескольких кодовых точек, склеенных невидимым соединителем U+200D, так что один значок на экране может дать в таблице пять строк. Из-за этого счётчики расходятся: поле формы считает символы по единицам UTF-16, база меряет байты, а человек видит одну картинку.
| Символ | Код | Как выглядит | Откуда берётся |
|---|---|---|---|
| Неразрывный пробел | U+00A0 | Как обычный пробел | Вёрстка, Word, копирование со страниц. |
| Узкий неразрывный пробел | U+202F | Как узкий пробел | Разряды в числах, типографика. |
| Пробел нулевой ширины | U+200B | Ничего | Переносы в вёрстке, копирование из браузера. |
| Соединитель нулевой ширины | U+200D | Ничего | Склеивает части составного эмодзи. |
| Мягкий перенос | U+00AD | Ничего или дефис при переносе | PDF, вёрстка книг. |
| Метка порядка байтов | U+FEFF | Ничего | Начало файла, сохранённого редактором. |
| Латинские a, c, e, o, p, x | U+0061 и соседи | Как кириллические буквы | Подмена в паролях, названиях и адресах. |
История: от кодовых страниц до эмодзи
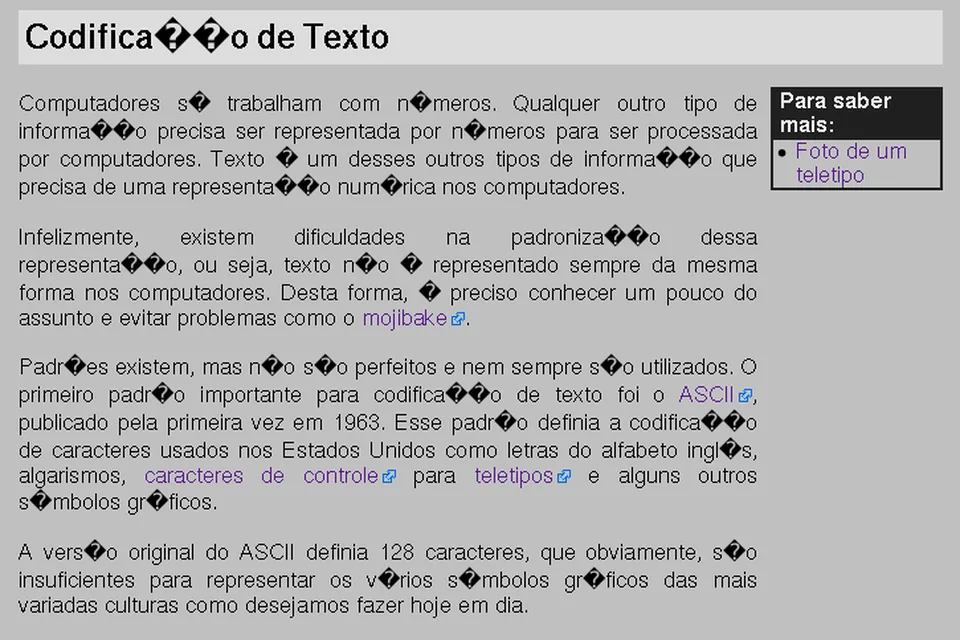
До Unicode каждый алфавит жил в своей восьмибитной таблице, и русскому тексту досталось сразу несколько: КОИ-8, Windows-1251, ISO 8859-5, DOS-866 и кириллица «Макинтоша». Пока текст оставался внутри одной системы, всё работало; при переносе буквы превращались в «кракозябры». Хуже того, японский или греческий текст в русскую таблицу не помещался вовсе; смешать в одном файле три алфавита было нельзя.
Выход предложили в 1987 году Джо Беккер из Xerox вместе с Ли Коллинзом и Марком Дэвисом из Apple: одна таблица на все письменности мира. Название Unicode появилось в черновике Беккера 1988 года, в январе 1991 года учредили консорциум, а в октябре вышел первый том стандарта. Тогда казалось, что шестнадцати бит хватит на всё; сегодня пространство расширено, а в стандарте больше 150 000 символов, включая древние письменности и нотные знаки.
Оставалось решить, как хранить эти номера в байтах. В сентябре 1992 года Кен Томпсон и Роб Пайк придумали UTF-8: символ занимает от одного до четырёх байтов, первые 128 кодов совпадают с ASCII, и старые программы продолжают работать. Это и сделало Unicode повсеместным. В 2010 году в стандарт вошли эмодзи, за ними потянулись модификаторы тона кожи и соединители, а вместе с ними и странности вроде значка, который состоит из семи кодовых точек.

Как найти невидимку и починить строку
Вставьте строку целиком — пароль, имя файла, ячейку из выгрузки, адрес. Сначала смотрите на счётчики: сколько символов, сколько байт, сколько невидимых и смешанных знаков. Если невидимых нет, а строки всё равно не совпадают, сравнивайте посимвольно коды: чаще всего расходятся буквы-двойники из разных алфавитов или похожие дефисы и кавычки, которых в Unicode по десятку.
Дальше действуют по ситуации. Невидимые знаки убирают, перенабрав строку вручную или пропустив её через текстовый редактор без форматирования. Смешанные алфавиты чинит латиница в кириллице и невидимые символы: он заменяет чужие буквы на местные. Когда нужен разбор целой строки одним форматом — байтами или кодами подряд, — удобнее Таблица ASCII. Текст остаётся в браузере, поэтому в инспектор можно вставлять пароли и рабочие данные.
| Кодовая точка | U+ и шестнадцатеричное число |
| Диапазон | U+0000 — U+10FFFF |
| Символов в стандарте | больше 150 000 |
| UTF-8 | от 1 до 4 байтов |
| UTF-16 | по 2 байта, выше U+FFFF — пара |
| Кириллица в UTF-8 | 2 байта |
| Неразрывный пробел | U+00A0 |
| Первый том стандарта | 1991 |
Как пользоваться
Инспектор разбирает текст по символам и для каждого показывает код U+XXXX, десятичный номер, байты UTF-8, кодовые единицы UTF-16, HTML-сущность и группу — кириллица, латиница, цифра, пробел, эмодзи, — а невидимые и подозрительные символы подсвечивает и считает. Полезно, когда пароль «не подходит», поиск по странице «не находит» или строка в базе не совпадает с такой же на вид. Проверено 04.09.2026.
- Любой: слово, пароль, строку из таблицы, адрес.
- Сколько символов, байт, невидимых и смешанных знаков.
- Невидимые и нестандартные пробелы, символы нулевой ширины, латиница среди кириллицы выделены в таблице.
- U+код, число, байты и HTML-сущность для каждого символа.
Частые вопросы
Что такое кодовая точка и U+
Номер символа в Unicode, записанный в шестнадцатеричной системе с префиксом U+: буква «я» — U+044F, то есть 1103. В UTF-8 этот номер занимает два байта D1 8F, в UTF-16 — одну единицу 044F.
Какие символы невидимые
Неразрывный пробел U+00A0, тонкие пробелы U+2009 и U+202F, символы нулевой ширины U+200B–U+200D, мягкий перенос U+00AD, метка порядка байтов U+FEFF, знаки направления письма. Инспектор находит их и показывает код.
Почему одинаковые слова не совпадают
Чаще всего из-за смешанных алфавитов: латинские a, c, e, o, p, x, y выглядят как кириллические. Инспектор помечает латиницу в слове с кириллицей и наоборот; отдельный инструмент сайта заменяет их автоматически.
Чем UTF-8 отличается от UTF-16
Оба кодируют одни и те же символы: UTF-8 переменной длиной от одного до четырёх байт и обратно совместим с ASCII, UTF-16 единицами по два байта, символы выше U+FFFF занимают две единицы — суррогатную пару. JavaScript считает длину строки в UTF-16.
Почему эмодзи — несколько символов
Флаги, семьи и тона кожи собираются из нескольких кодовых точек, соединённых знаком U+200D. Инспектор показывает каждую часть отдельно, поэтому один эмодзи может дать 3–7 строк.
Считает ли инспектор длину для SMS или Твиттера
Он показывает число символов и байт; лимиты площадок считает отдельный счётчик символов на сайте.
Спросите нейросети об инструменте
Похожие инструменты
Находит латинские буквы внутри русских слов и спрятанные символы: неразрывные пробелы, нулевую ширину, мягкий перенос. Правит выборочно: трогает только эти символы.
ОткрытьТаблица ASCIIПолная таблица печатных символов ASCII с кодами плюс конвертер текста в байты, HEX, двоичный код и HTML-коды.
ОткрытьСравнить два JSONПоказывает, чем отличаются два ответа API: какие поля появились, пропали и изменились, с путём вида data.items[0].price. Служебные поля можно исключить.
ОткрытьШифр ВиженераШифрование и расшифровка по ключевому слову, а также шифр Цезаря со сдвигом и Атбаш, русский и латинский алфавиты, таблица Виженера.
ОткрытьКартинка в Base64Изображение в data URI для HTML и CSS и обратно: размер до и после, готовые фрагменты img и background, предпросмотр из строки.
ОткрытьСканер QR-кодаСчитывает QR-код и штрихкод камерой или с картинки прямо в браузере: ссылка, Wi-Fi, визитка, телефон и номер товара разбираются по полям.
ОткрытьЕщё инструменты для кода и данных
Base64 и URL, форматтер и сравнение JSON, хеши, регулярные выражения, cron, подсети, UUID, QR-код и Unix-время — в разделе 42 инструмента.