 Паветта
Текст в двоичный код и обратно
Компьютер хранит текст числами: у каждого символа есть номер в таблице Unicode, а в памяти он лежит байтами UTF-8. Латинская «A» — это 65, в двоичном 01000001, один байт; русская «я» — кодовая точка 1103 (U+044F), но в UTF-8 это два байта 11010001 10001111.
По символам
От символа к байтам и обратно
Компьютер хранит текст числами: у каждого символа есть номер в таблице Unicode, а в памяти этот номер записан байтами. Инструмент показывает всю цепочку — символ, его код, двоичную запись — и переводит в обе стороны, включая шестнадцатеричную форму.
Кодировка UTF-8 записывает символ переменным числом байтов. Латинская буква занимает один байт, кириллическая два, знаки вроде тире и типографских кавычек — три, эмодзи четыре. Отсюда практическое следствие: русский текст в UTF-8 весит примерно вдвое больше английского той же длины.
Устроена кодировка так, что начало символа всегда узнаваемо: первый байт говорит, сколько байтов занимает знак, а продолжающие байты начинаются с фиксированной комбинации бит. Поэтому потерянный кусок потока не ломает разбор целиком — синхронизация восстанавливается на следующем символе.
| Символ | Код Unicode | Байтов в UTF-8 |
|---|---|---|
| A | U+0041 | 1 |
| Ж | U+0416 | 2 |
| — | U+2014 | 3 |
| 😀 | U+1F600 | 4 |
ASCII, Unicode и салфетка в закусочной
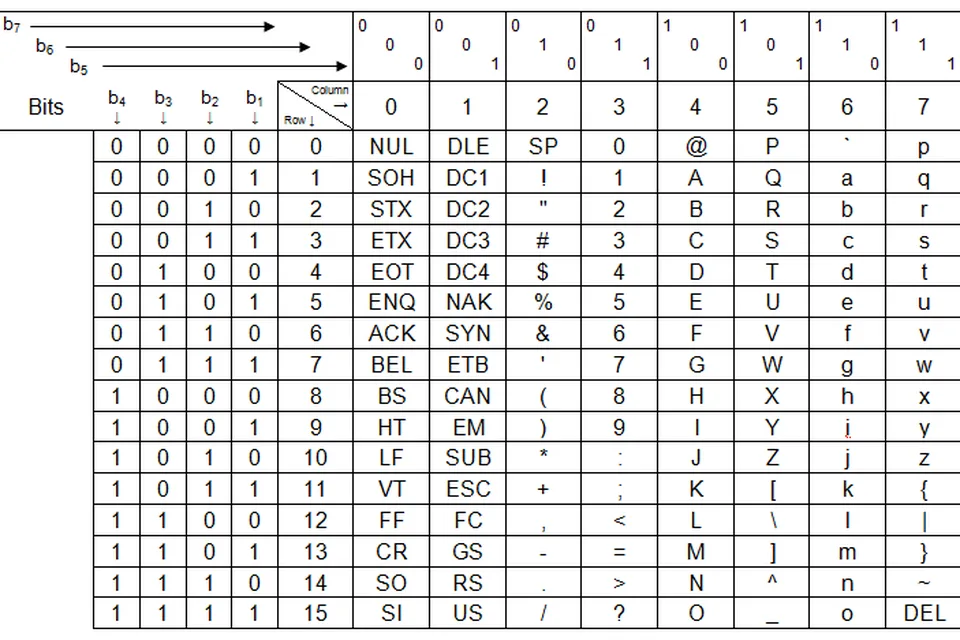
Таблица ASCII появилась в 1963 году и описывала сто двадцать восемь знаков: латиница, цифры, знаки препинания и управляющие коды. Семи бит хватало, восьмой оставался свободным, и его пустили под национальные буквы — каждая страна по-своему. Отсюда десятки несовместимых кодировок и русский текст, превращающийся в набор случайных латинских букв.
Unicode задумали как единую таблицу для всех письменностей мира. Первая версия вышла в 1991 году, сегодня стандарт описывает больше ста пятидесяти тысяч знаков и обновляется ежегодно. Номер знака в нём принято писать как U+ и шестнадцатеричный код.
Кодировку UTF-8 придумали Кен Томпсон и Роб Пайк в 1992 году. Историю рассказывают так: они набросали схему на салфетке в закусочной, а к утру Томпсон её реализовал. Ключевое достоинство — совместимость: текст из одной латиницы в UTF-8 байт в байт совпадает с тем же текстом в ASCII. Отдельная история — порядок байтов в многобайтовых числах: одни архитектуры пишут старший байт первым, другие последним, и при обмене данными между ними это приходится учитывать явно.
Как читать чужую двоичную строку
Вставьте текст — получите двоичную запись, вставьте биты — получите текст. Разделитель между байтами настраивается: пробел удобен глазу, слитная запись нужна, когда результат идёт в другую программу.
При разборе чужой двоичной строки сначала посмотрите на длину: если число бит делится на восемь, перед вами байты, если на семь — старая семибитная запись. Кириллица в UTF-8 всегда даёт пары байтов, начинающиеся с комбинации 110, и это заметно на глаз.
Помните, что двоичная запись не защищает данные: она читается так же легко, как исходный текст. Для сокрытия нужен шифр, для проверки целостности — хеш. Перевести число между системами счисления поможет конвертер систем счисления.
Отдельная тонкость — символы, состоящие из нескольких кодовых точек. Флаги, семьи и знаки с модификаторами цвета кожи собираются из двух и более точек, и подсчёт длины строки в таких случаях расходится с тем, что видит глаз.
Помните про невидимые знаки. Неразрывный пробел, мягкий перенос и метка порядка байтов в двоичной записи выглядят как обычные байты, и найти их в тексте иначе как через коды почти невозможно. Именно они чаще всего ломают сравнение строк, которые на экране выглядят совершенно одинаково, и поиск такой причины занимает больше времени, чем вся остальная отладка.
| Таблица ASCII | 1963 |
| Знаков в ASCII | 128 |
| Первая версия Unicode | 1991 |
| Знаков сегодня | больше 150 000 |
| Авторы UTF-8 | Томпсон и Пайк |
| Год UTF-8 | 1992 |
| Латиница в UTF-8 | 1 байт |
| Кириллица в UTF-8 | 2 байта |
Как пользоваться
Калькулятор переводит текст в двоичный, шестнадцатеричный, восьмеричный и десятичный вид двумя способами — по байтам UTF-8, как в файле, и по кодовым точкам, как в учебнике, — и обратно: вставьте двоичный или hex-код, получите текст. Разделитель между группами, ширина группы в 8 бит и таблица по каждому символу настраиваются. Проверено 04.09.2026.
- Направление определяется автоматически: если в поле только нули, единицы и пробелы — это код.
- Двоичная, шестнадцатеричная, восьмеричная или десятичная.
- Байты UTF-8 — как в файле и в сети; кодовые точки Unicode — как в задачнике по информатике.
- Кнопка копирует код, таблица показывает символ за символом.
Частые вопросы
Как перевести букву в двоичный код
Найти её номер в таблице символов и записать в двоичной системе. «A» — 65 = 01000001. Для русских букв номер больше 255, и в одном байте он не помещается: в UTF-8 такая буква занимает два байта и по кодовой точке записывается 16 битами.
Чем отличаются байты UTF-8 от кодовых точек
Кодовая точка — номер символа в Unicode, один на символ. UTF-8 — способ уложить этот номер в байты: латиница в один, кириллица в два, иероглифы в три, эмодзи в четыре. Файлы и сеть хранят байты, поэтому «привет» в UTF-8 — 12 байт.
Почему в коде группы по 8 бит
Байт — восемь бит, и ведущие нули сохраняются, чтобы границы байтов были видны: 65 записывается как 01000001, восемь знаков вместо семи. Для кодовых точек группы по 16 бит.
Как перевести двоичный код обратно в текст
Разбить на байты по восемь бит, каждый перевести в число и собрать символы по правилам UTF-8. Калькулятор делает это сам, если вставить код: пробелы между байтами необязательны.
Что такое hex-представление
Та же запись, но в шестнадцатеричной системе: один байт — две цифры 0–9 и A–F. «A» — 41, «я» — D1 8F. Так байты показывают hex-редакторы и отладчики.
Работает ли с эмодзи
Да: эмодзи — четыре байта в UTF-8, кодовая точка выше U+FFFF. Составные эмодзи с модификаторами показываются как несколько кодовых точек.
Спросите нейросети об инструменте
Больше возможностей: Нейросеть для текста, написать, сократить, переписать.
Похожие инструменты
Двоичная, восьмеричная, десятичная и шестнадцатеричная плюс любое основание от 2 до 36. Дробная часть и проверка недопустимых цифр.
ОткрытьСравнить два JSONПоказывает, чем отличаются два ответа API: какие поля появились, пропали и изменились, с путём вида data.items[0].price. Служебные поля можно исключить.
ОткрытьАзбука МорзеТекст в код Морзе и обратно на русском и латинице, цифры и знаки, звук с регулируемой скоростью, полная таблица.
ОткрытьChmod калькуляторПрава доступа Linux в трёх видах: галочки, число 755 и строка rwxr-xr-x. Специальные биты и готовая команда.
ОткрытьГенератор UUIDВерсии 4 и 7 пачками, пять форматов записи и разбор готового идентификатора с датой создания для v7.
ОткрытьТестер регулярных выраженийПодсветка совпадений и групп, режим замены и разбор самого шаблона по-русски: что делает каждый кусок и почему выражение не сработало.
ОткрытьЕщё инструменты для кода и данных
Base64 и URL, форматтер и сравнение JSON, хеши, регулярные выражения, cron, подсети, UUID, QR-код и Unix-время — в разделе 42 инструмента.