Сервисы для сбора семантического ядра и частотности
Проверено 30.08.2026
Всё, что происходит до написания текста: снять частотность, вытащить подсказки, оценить конкуренцию и разложить фразы по группам. Ошибка на этом шаге дороже всех последующих — под неверно собранное ядро пишут страницы, которые потом некуда девать.
Если поля нет в карточке, на сайте сервиса про это ничего не сказано.
Как выбирать в этом разделе
Отправная точка одна для всех — Вордстат, но его цифра показывает число показов и включает все вложенные фразы. Переходов будет в разы меньше, и точную частотность формулировки дают операторы кавычек и восклицательного знака. Дальше выбор упирается в объём: десяток запросов проверяют руками, ядро на десятки тысяч фраз собирают программой со своими прокси или облачным сервисом, который берёт эту работу на себя.
Путь от источника до готовой группы
Шаг 1
Источники
Вордстат, подсказки, конкуренты
Шаг 2
Чистка
стоп-слова, дубли, мусор
Шаг 3
Частотность
операторы кавычек и восклицания
Шаг 4
Кластеризация
группы по составу топа
Ошибка на первом шаге дороже всех последующих: под кривое ядро пишут страницы, которые потом некуда девать.
Шаги 2 и 3 закрываются нашими бесплатными инструментами, если объём небольшой.
Три числа, которые называют частотностью
Один и тот же запрос в отчётах выглядит по-разному, и разница бывает в десятки раз.
Базовая частотность
Запрос и все его формы вперемешку. Показывает размер темы и почти всегда завышает интерес к конкретной фразе.
Точная частотность
Фраза в кавычках и с оператором: сколько раз спрашивали именно так. Основа для планирования.
Сезонность
История по месяцам. Без неё летний спад легко принять за проваленное продвижение.
Три разных числа для одного и того же запроса. Планировать по базовой частотности — самая частая ошибка на старте.
Практическое следствие: страницу под запрос заводят по точной частотности, а тему целиком оценивают по базовой. Если перепутать, получится сайт под запросы, которых никто не задаёт в такой формулировке.
И про источник цифр. Частотность живёт в инструментах поисковых систем, а сторонние сервисы её оттуда забирают и обрабатывают. Поэтому расхождения между сервисами нормальны, а сравнивать между собой имеет смысл цифры из одного источника.
Что здесь можно сделать бесплатно
Спрос на «сервис сбора семантики бесплатно» устойчивый, и ответ на него честный: значительную часть работы действительно можно сделать без оплаты.
Бесплатно и полноценно
Частотность и история спроса в инструменте поисковика, подсказки поисковой строки, запросы из панели вебмастера, «Похожие запросы» в выдаче.
Бесплатно, но с потолком
Пробные лимиты сервисов: хватает на один небольшой проект, дальше упирается в число запросов и скорость.
За что платят
Массовый съём частотности, парсинг подсказок пачками, кластеризация по выдаче и хранение проектов.
Первый столбец закрывает семантику небольшого сайта целиком. Платят за объём и за автоматизацию рутины.
Момент, когда бесплатного перестаёт хватать, наступает предсказуемо: когда запросов становится тысячи и снимать частотность руками дольше, чем стоит подписка.
Видео: как это выглядит в работе
Не рекламный фон: в роликах видны установка, интерфейс и первые действия. Плеер загружается только после клика.
Новый Яндекс Вордстат 2024 - как пользоваться и собирать ключевые фразыОбновлённый Вордстат на живых примерах: как проверить спрос на услугу, найти формулировки, которыми ищут люди, посмотреть динамику по месяцам и разрез по регионам. Всё показано записью экрана.
SEO в 2026 году — Эффективный парсинг Яндекс Вордстат с Key Collector 4Практика в Key Collector 4: настройка сбора через XML-сервис, запуск парсинга Вордстата и разбор таблицы с частотами. Видно окно программы и то, как выглядит работа с ядром.
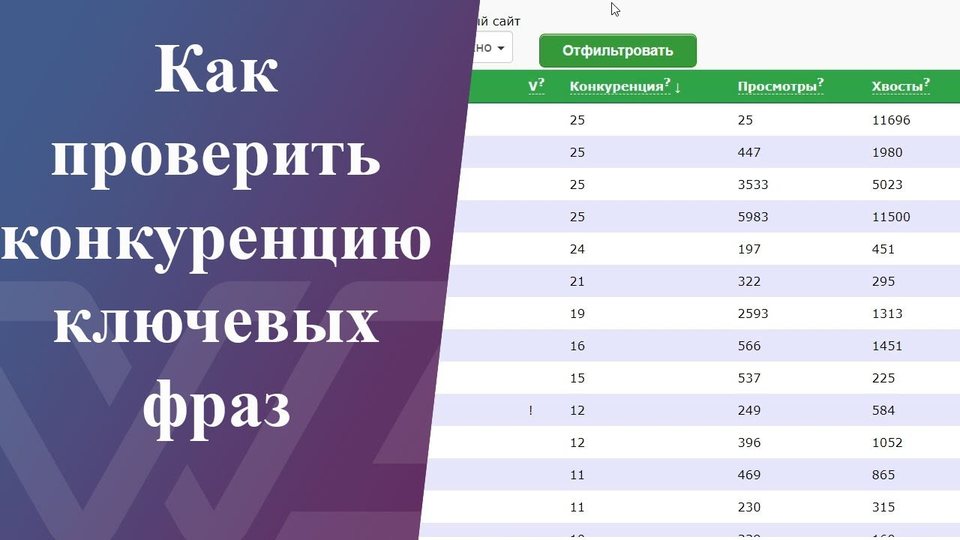
Как проверить конкурентность запросов - обзор Mutagen.ruДмитрий Ярошок показывает Мутаген на своих запросах: разовая и массовая проверка конкурентности, оценка стоимости продвижения и выгрузка результатов в таблицу для дальнейшей работы с ядром.
С Вордстата и подсказок поиска: они показывают, какими словами задачу формулируют люди. Кластеризация и чистка идут следом, когда есть что чистить.
Чем базовая частотность отличается от точной?
Базовая цифра включает все вложенные фразы и словоформы, поэтому она всегда больше. Точную дают операторы кавычек и восклицательного знака. Разница на порядок — обычное дело, и планировать по базовой означает переоценить спрос в разы.
Можно ли собрать ядро бесплатно?
Небольшое — да: источником служит Вордстат, а чистка, снятие дублей и кластеризация закрываются бесплатными инструментами. Платный сервис нужен на объёме, где ручной сбор занимает уже дни.
Нужна ли программа, если запросов немного?
Под сотню фраз собираются руками в таблице. Программы и облачные сервисы начинают окупаться там, где появляются тысячи фраз, капча и необходимость повторять сбор.
Как собрать семантическое ядро?
В четыре шага: собрать источники запросов, вычистить мусор и нецелевое, снять частотность и разложить запросы по группам. Инструменты этого раздела закрывают первый, третий и четвёртый шаг, второй остаётся ручным.
Можно ли собрать семантику бесплатно?
Для небольшого сайта — да. Частотность и история спроса есть в инструменте поисковика, подсказки видны в строке поиска, реальные запросы к вашему сайту лежат в панели вебмастера. Платить начинают за объём и за автоматизацию, когда запросов становятся тысячи.
Чем базовая частотность отличается от точной?
Базовая считает запрос вместе со всеми его формами и уточнениями и потому сильно завышает интерес к конкретной фразе. Точная показывает, сколько раз спрашивали именно так. Страницы планируют по точной.
Что такое кластеризация запросов?
Разбиение собранных запросов на группы, каждая из которых закрывается одной страницей. Автоматическая кластеризация делает это по совпадению сайтов в выдаче: если по двум запросам поиск показывает одни и те же страницы, значит он считает их одной темой.
 Паветта