 Паветта
llama3.1Meta · 121,1 млн скачиваний
Модель Meta третьего поколения, версия 3.1: размеры 8B, 70B и 405B.
инструменты
ollama run llama3.1:8b
Ollama 0.40.16 от 9 ноября 2026 — программа для запуска открытых моделей на своём компьютере. Установка по системам, требования, команды и API.
irm https://ollama.com/install.ps1 | iexcurl -fsSL https://ollama.com/install.sh | shcurl -fsSL https://ollama.com/install.sh | shcurl -fsSL https://ollama.com/download/ollama-linux-amd64.tar.zst | sudo tar x -C /usrcurl -fsSL https://ollama.com/download/ollama-linux-amd64-rocm.tar.zst | sudo tar x -C /usrcurl -fsSL https://ollama.com/download/ollama-linux-arm64.tar.zst | sudo tar x -C /usrcurl -fsSL https://ollama.com/install.sh | OLLAMA_VERSION=0.5.7 shdocker run -d -v ollama:/root/.ollama -p 11434:11434 --name ollama ollama/ollamadocker run -d --gpus=all -v ollama:/root/.ollama -p 11434:11434 --name ollama ollama/ollamadocker run -d --device /dev/kfd --device /dev/dri -v ollama:/root/.ollama -p 11434:11434 --name ollama ollama/ollama:rocmdocker exec -it ollama ollama run llama3.2Модель Meta третьего поколения, версия 3.1: размеры 8B, 70B и 405B.
ollama run llama3.1:8b
Семейство открытых моделей DeepSeek с рассуждением: от 1,5B до 671B.
ollama run deepseek-r1:1.5bМалые модели Meta Llama 3.2 на 1B и 3B параметров.
ollama run llama3.2:1b
Модели Alibaba Qwen2.5: обучены на 18 трлн токенов, контекст до 128K, много языков.
ollama run qwen2.5:0.5bТретье поколение Qwen от Alibaba: плотные модели и смесь экспертов (MoE) от 0,6B до 235B.
ollama run qwen3:0.6b
Gemma 3 от Google: модели от 270M до 27B, понимают картинки, рассчитаны на одну видеокарту.
ollama run gemma3:270mПодобрать под свою видеокарту или Mac — инструмент подбора.
ollama run gemma4Скачать при необходимости и запустить чат с модельюollama pull gemma4Скачать модельollama lsСписок скачанных моделейollama psМодели в памяти и доля GPU/CPUollama stop gemma4Выгрузить запущенную модельollama rm gemma4Удалить модель с дискаollama serveЗапустить сервер; --help покажет переменныеollama create -f ModelfileСобрать свою модель из Modelfileollama launchПодключить Claude Code, Codex и др. к моделямollama signinВойти в аккаунт для облачных моделейollama -vПроверить, что Ollama запущенаЕсли видеопамяти мало, Ollama использует ОЗУ, ответы идут медленнее.
Колонка PROCESSOR в ollama ps: 100% GPU, 100% CPU или, например, 48%/52% CPU/GPU — модель разделена между видеокартой и ОЗУ.
Для скорости документация советует не выгружать модель на процессор.
Если модель помещается на одну видеокарту, она грузится на неё; иначе делится на все доступные.
Выбор карт NVIDIA — CUDA_VISIBLE_DEVICES; принудительно процессор — неверный номер GPU, например -1.
С сентября 2025 года планировщик измеряет точный объём памяти под модель вместо оценки.
Модель остаётся в памяти 5 минут после запроса.
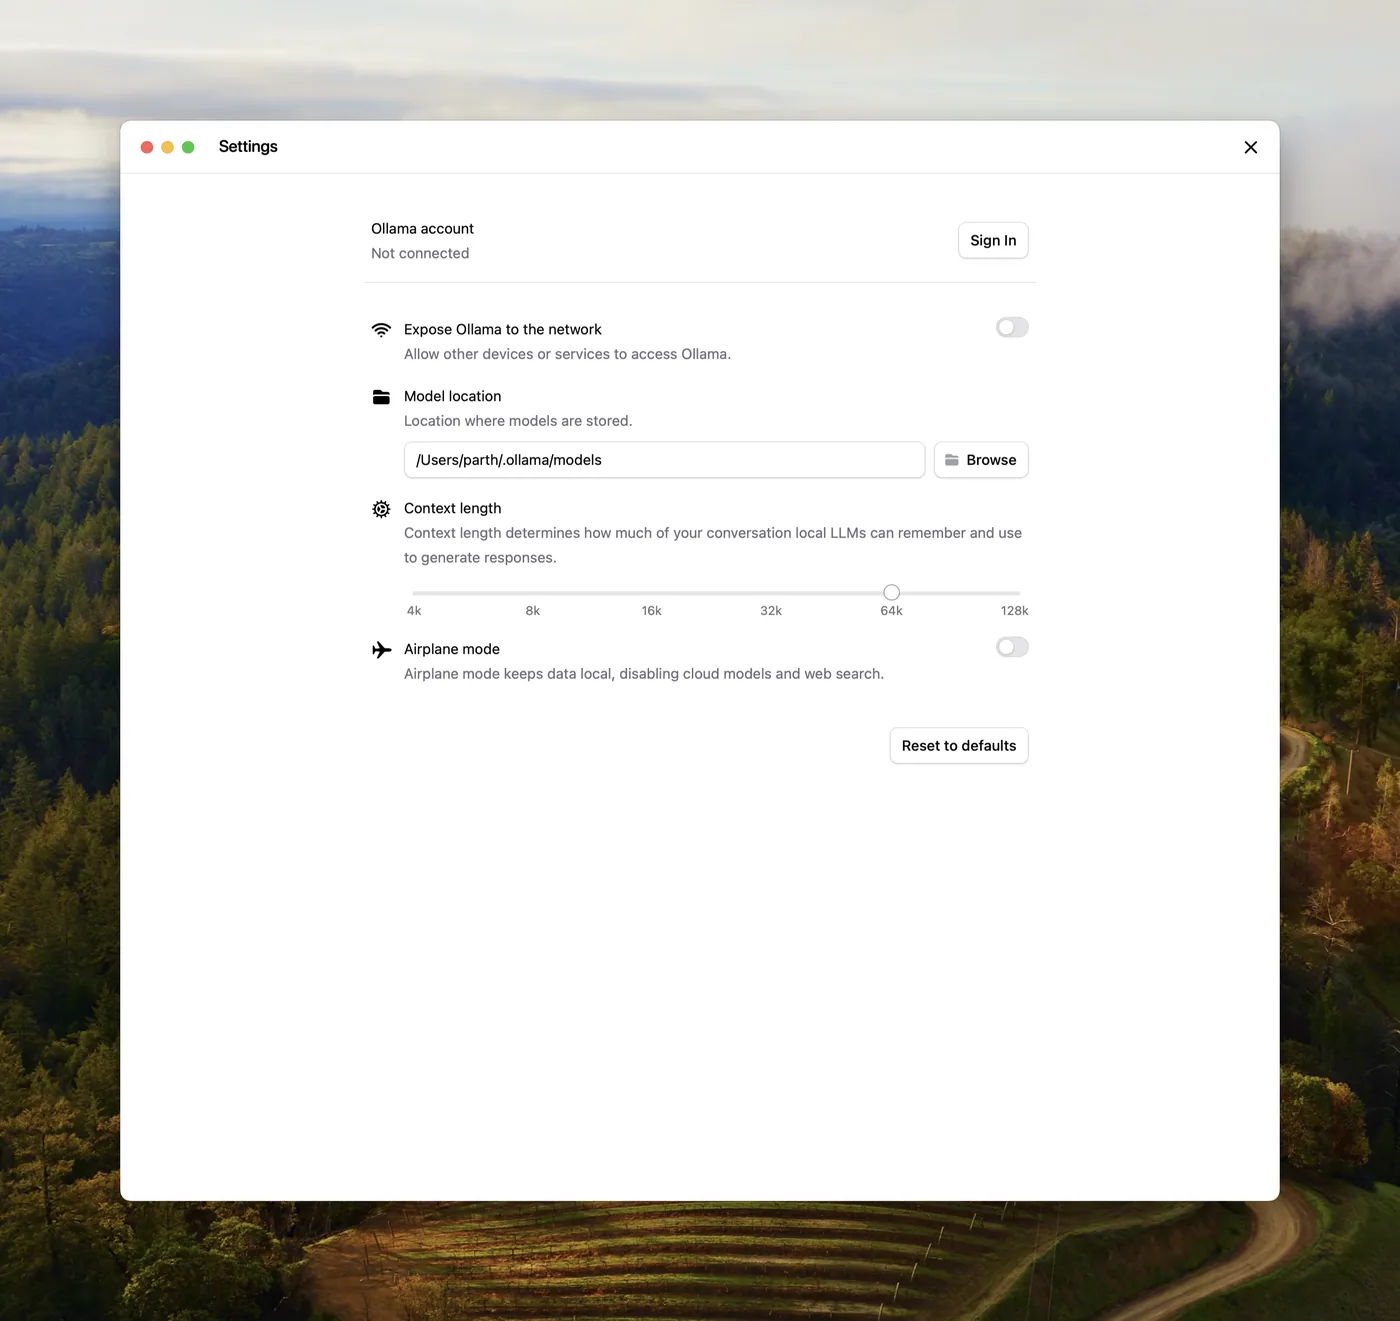
Контекст по умолчанию зависит от видеопамяти: меньше 24 ГиБ — 4k, 24–48 ГиБ — 32k, от 48 ГиБ — 256k.
Для поиска в сети, агентов и программирования советуют не меньше 64 000 токенов.
Изменить: ползунок в настройках приложения; OLLAMA_CONTEXT_LENGTH=64000 ollama serve; в чате /set parameter num_ctx 4096; в API параметр options.num_ctx.
Больше контекст — больше памяти под модель.
Облачные модели работают с максимальным контекстом.
Расхождение в документации: в FAQ контекст по умолчанию 4096 токенов, в справке Modelfile для num_ctx указано 2048.
macOS: ~/.ollama/models
Linux: /usr/share/ollama/.ollama/models
Windows: C:\Users\%username%\.ollama\models
Папку меняет переменная OLLAMA_MODELS; на Linux пользователю ollama нужны права: sudo chown -R ollama:ollama <папка>.
Где задавать переменные: macOS — launchctl setenv, Linux — systemctl edit ollama.service, Windows — переменные среды учётной записи.
Ollama Cloud запущен в превью 19 сентября 2025 года: крупные модели на серверах Ollama.
Облако нужно для моделей, которым не хватает домашней видеокарты; выполнение идёт на серверах Ollama.
Облачные функции отключаются переменной OLLAMA_NO_CLOUD=1.
Облако по подписке: Pro 20 $ в месяц (60 $ кредитов), Max 100 $ (300 $), Team 500 $ (1 000 $ на команду); оплата облачных моделей за токены.
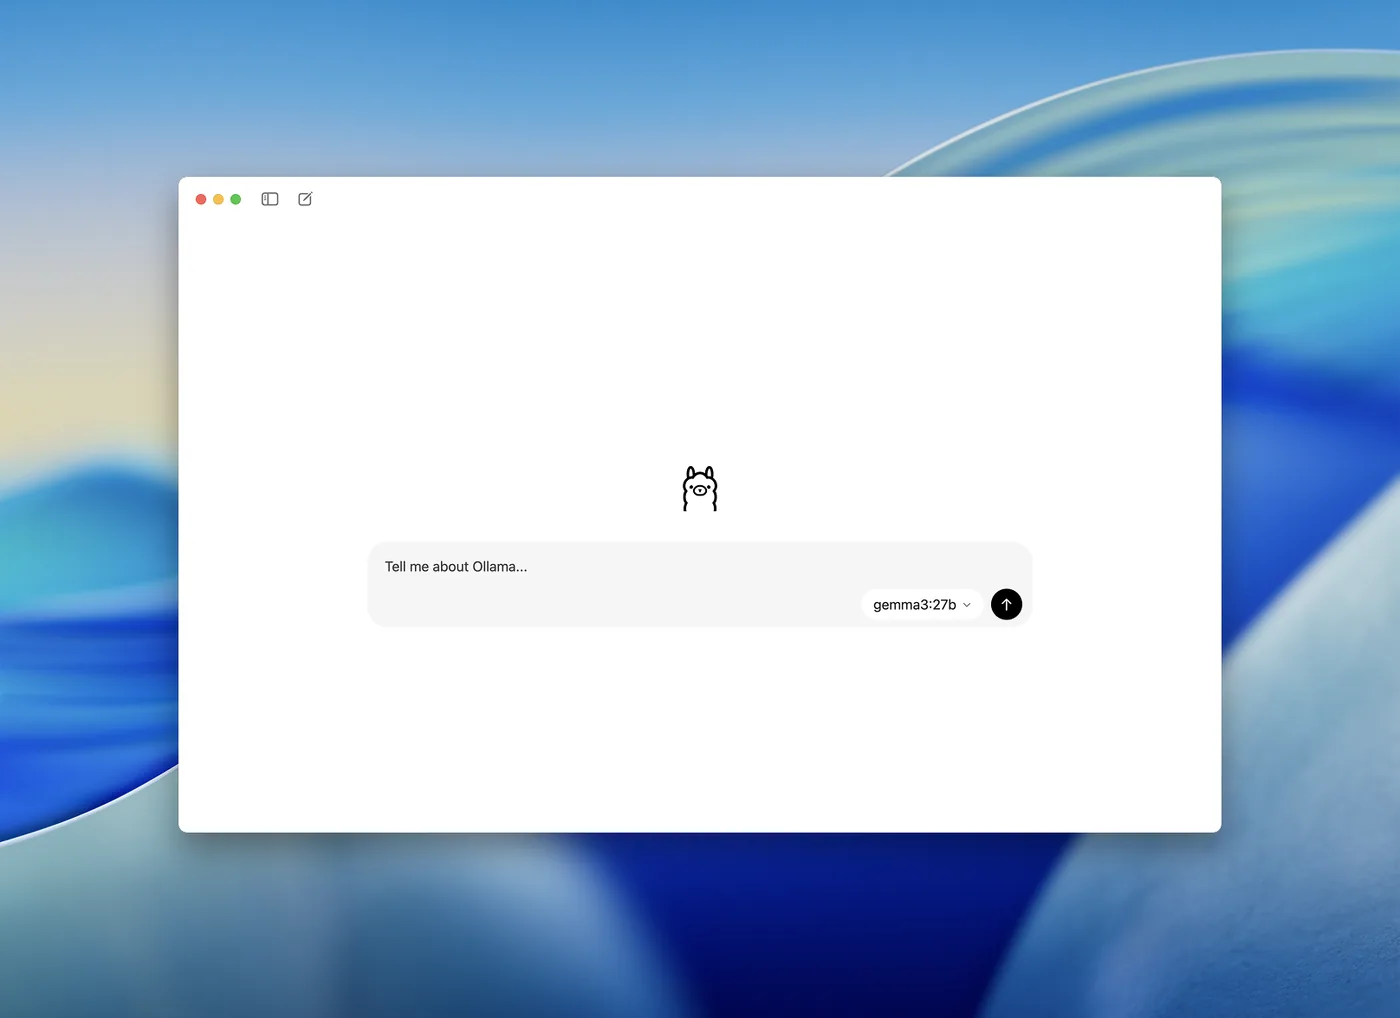
Синтез речи. Модели речи, первая — Phonon; пока на macOS.
Модели-классификаторы (decision models). Ответы да/нет, выбор метки и оценка по шкале через ollama run --ask.
Новые тарифы облака. Pro, Max и Team с оплатой за токены и ежемесячным запасом кредитов.
Claude Desktop через Ollama. Claude Desktop подключается к Ollama как сторонний шлюз.
Ollama 0.30: GGUF через llama.cpp и Vulkan по умолчанию. Больше моделей GGUF и ускорение на AMD и Intel без отдельных библиотек.
MLX на Apple Silicon (превью). Ollama 0.19 на Mac работает поверх MLX.
Команда ollama launch. Настраивает и запускает Claude Code, OpenCode, Codex с локальными или облачными моделями.
Генерация картинок (эксперимент). Пока на macOS, Windows и Linux обещаны позже.
Совместимость с Anthropic Messages API. С версии 0.14.0 к Ollama подключается Claude Code.
В выдаче Яндекса по «ollama скачать» (16.11.2026) первой идёт ollama.com/download; доменов, похожих на ollama.com, в первой странице нет.
В выдаче есть каталоги программ softsalad.ru и ollama.softonic.ru и сторонняя оболочка OllaMan (ollaman.com); их файлы не проверялись.
ollama.org перенаправляет на ollama.com (301).
local-ai.com.ru — сайт с инструкциями, своего установщика Ollama не раздаёт.
Установщики на ollama.com: /download/OllamaSetup.exe и /download/Ollama.dmg.