

Проверка «на ИИ» и проверка на уникальность отвечают на разные вопросы, и путать их дорого. Разбираю десять признаков, по которым машинный текст узнают без всяких сервисов, показываю на цифрах, где проходит граница между живым и сгенерированным, и объясняю, почему ни один детектор не годится в качестве доказательства.
- Уникальность и машинность — разные вещи: сгенерированный текст почти всегда уникален на 95–100%.
- Признаков десять: семь видны в тексте (штампы, связки, антитеза «не X, а Y», усилители, обобщения, тройки, прямые улики чат-бота), три считаются по структуре.
- Главный структурный признак — ровность длины фраз: у живых текстов разброс выше 0,5, у машинных падает до 0,3.
- OpenAI закрыла собственный детектор ИИ в июле 2023 года из-за низкой точности. Обвинять автора по проценту нельзя.
- Поиск наказывает за пустоту; способ создания текста его не волнует. Высокий процент — сигнал переписать.
| Признак | Как выглядит | Насколько показателен |
|---|---|---|
| Ровность длины фраз | предложения одинаковой длины подряд | высокий |
| Штампы-связки | «таким образом», «в целом», «стоит отметить» | высокий |
| Антитеза «не X, а Y» | постоянные противопоставления в каждом абзаце | высокий |
| Обобщения без цифр | «многие эксперты», «часто бывает» | средний |
| Тройки перечислений | три однородных пункта в каждом предложении | средний |
| Отсутствие деталей | нет имён, дат, сумм и названий инструментов | средний |
| Идеальная структура | ровно по три подпункта в каждом разделе | низкий |
Чем проверка на нейросеть отличается от проверки на уникальность
Эти две проверки отвечают на разные вопросы, и путаница между ними стоит людям нервов. Уникальность ищет совпадения: брали ли этот кусок с чужой страницы. Проверка на нейросеть смотрит на манеру письма и не сравнивает текст ни с чем внешним.
Отсюда парадокс, с которым сталкивается каждый, кто первый раз прогоняет машинный текст через антиплагиат. Сгенерированная статья почти всегда показывает 95–100% уникальности. Модель не копирует абзацы, она собирает фразу заново из вероятностей — совпадать буквально ей не с чем. Формально придраться не к чему. Читать невозможно.
Обратный случай встречается не реже. Ваш собственный текст про типовую услугу покажет 70% уникальности просто потому, что «замена масла за 40 минут» пишется примерно одинаково у всех автосервисов страны. Живой, полезный, написанный руками — и низкая уникальность.
Поэтому две проверки не заменяют друг друга. Уникальность отвечает «откуда взят текст», проверка на нейросеть — «как он написан».
Десять признаков машинного текста
Нейросеть выдаёт себя не отдельным словом. Любой из признаков ниже встречается и у людей, узнаваемым текст делает их плотность и сочетание. Семь признаков видны глазом, три считаются по структуре и глазом не ловятся.
Откуда взяты признаки
Список ниже опирается на эссе русской Википедии «Признаки сгенерированности текста» (сокращённо ВП:ПРГЕН) — это самая полная открытая таксономия машинного письма на русском. Её ведут редакторы, которые вручную вылавливают сгенерированные статьи, и на неё ссылается правило о быстром удалении таких материалов. Ценность эссе в том, что оно собрано на реальных случаях: почти к каждому признаку там приложены живые примеры из отклонённых черновиков.
Я взял оттуда рамку категорий и добавил то, чего в энциклопедическом контексте нет: коммерческие штампы вроде «эффективное решение» и «широкий спектр услуг», на которых спотыкаются тексты для сайтов. Сами авторы эссе оговариваются, что список описывает наблюдения; запрещённых слов в нём нет: любой признак встречается и у живых людей, и вывод делается по их плотности.
Три структурных признака подсветить нельзя, они считаются по всему тексту:
- Ровность длины фраз. У человека предложения скачут: три слова, потом двадцать восемь. Нейросеть держит длину около среднего. Формально это коэффициент вариации — разброс, делённый на среднее. У живых текстов он обычно выше 0,5, у машинных падает до 0,3 и ниже.
- Доля конкретики. Сколько предложений содержат цифру, дату, название или имя. Фактов у модели нет, она пересказывает общее место, поэтому конкретика проваливается до единиц процентов.
- Плотность длинного тире. Модели ставят «—» заметно чаще пишущих людей, особенно в пояснительных вставках.
Отдельно стоит седьмой, самый однозначный признак — прямые улики чат-бота: служебные фразы вроде «надеюсь, это помогло», оговорки про предел знаний, остатки разметки Markdown и ссылки с меткой utm_source=chatgpt.com. Такое попадает в текст при копировании из чата. Служебная фраза и UTM-метка толкования не требуют; с разметкой осторожнее — Markdown пишут и руками, в заметках и на GitHub.
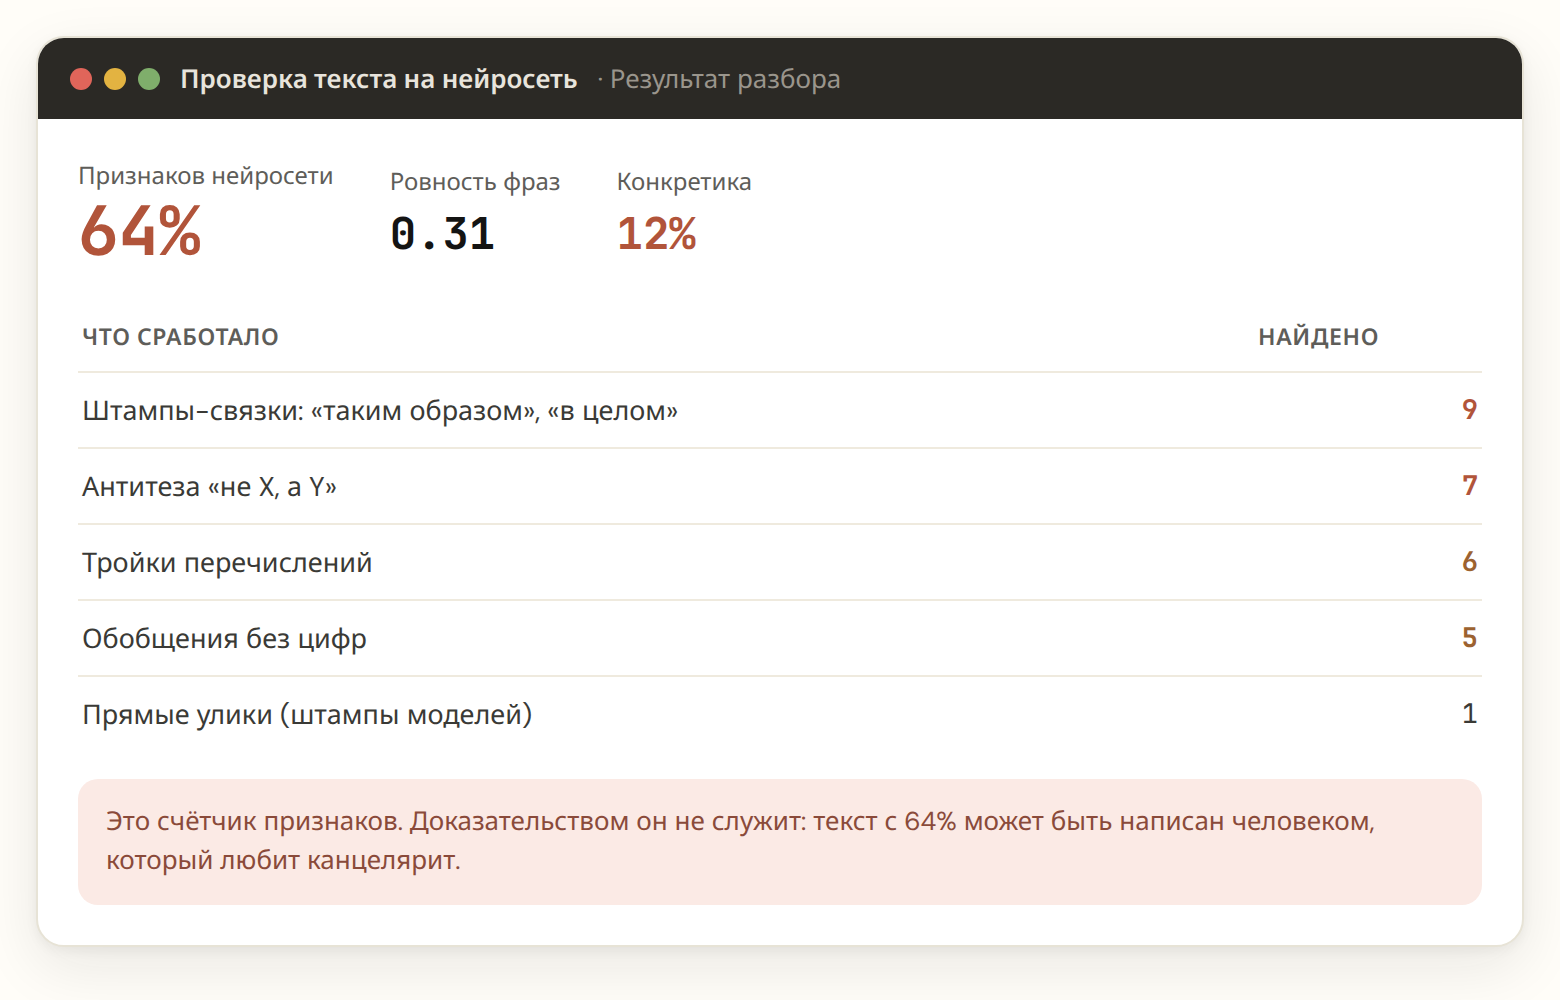
Все десять признаков считает проверка текста на нейросеть: первые семь подсвечивает прямо в тексте, последние три показывает цифрами в правой колонке.
Почему детекторам ИИ нельзя верить на слово
Соблазн получить машинный вердикт «писал робот» велик, но точность у таких инструментов принципиально ограничена, и это признают сами разработчики моделей.
В январе 2023 года OpenAI выпустила собственный классификатор AI Text Classifier — сервис, определяющий, написан ли текст их же моделью. В июле 2023 года компания его закрыла, прямо указав причиной низкую точность. Организация, у которой был полный доступ к обучающим данным GPT, не смогла надёжно отличить его вывод от человеческого письма.
Вторая проблема серьёзнее ложных срабатываний вообще: они распределены неравномерно. Исследование Стэнфордского университета 2023 года (Лян и соавторы, «GPT detectors are biased against non-native English writers») показало, что англоязычные детекторы систематически принимали за машинные тексты людей, для которых английский неродной. Причина ровно та, что описана выше: авторы, пишущие на неродном языке, используют более простой словарь и более ровные конструкции — то есть внешне выглядят как модель.
Для русского языка масштабных публичных исследований такого рода нет, но механизм тот же. Под подозрение попадает любой, кто пишет просто и ровно: технический писатель, юрист, переводчик, школьник.
Вывод простой: процент любого детектора годится как повод перечитать текст. Для обвинения автора он не годится. Требовать «понизить процент ИИ» от исполнителя так же осмысленно, как требовать понизить температуру за окном.
Детекторы ИИ: какие живы в 2026-м и насколько им верить
Выше мы разобрали признаки, по которым машинный текст видно глазами. Теперь про сервисы, которые обещают сделать это за тебя. В августе 2026-го я собрал замер практика: десять популярных детекторов, через которые прогоняли реальные ИИ-тексты. Все десять на момент проверки живы — вот что каждый из них умеет.
| Сервис | Русский | Бесплатно | Что показывает |
|---|---|---|---|
| text.ru/neuro/detector | Да, сервис российский | Нет, списывает нейросимволы | Процент вероятности генерации, от 100 до 50 000 знаков за проверку |
| Duplichecker | Есть русская версия интерфейса | Да, с регистрацией | Вердикт «человек/ИИ»; в первую очередь это антиплагиат, детектор ИИ у него побочный |
| AI Detector Writer | Да, интерфейс на русском | Да | Процент «человек/ИИ» и подсветку подозрительных предложений, принимает файлы .txt и .md |
| zerogpt.com | Заявляет поддержку всех языков | Да, до 15 000 знаков | Шкалу процента ИИ и подсветку предложений |
| zerogpt.net | Русского в списке языков нет | Да, до 20 000 знаков без регистрации | Вердикт «человек/ИИ»; заявлено 8 языков — русский среди них отсутствует |
| zerogpt.org | Русский не заявлен | Да, до 5 000 знаков, с аккаунтом больше | Вердикт «человек/ИИ» плюс встроенный хуманизатор — детектор и обход в одном окне |
| GPTZero | Русский не заявлен: английский, немецкий, французский, испанский, португальский | Да, до 10 000 знаков | Процент ИИ с подсветкой фраз; после покупки компанией Superhuman работает по-прежнему |
| Copyleaks | Да, свыше 30 языков включая русский | Да, до 25 000 знаков без регистрации | Вероятность ИИ по документу и по абзацам; на неанглийских языках точность ниже |
| Grammarly | Нет, ориентирован на английский | Да, базовая проверка | Процент текста, похожего на сгенерированный |
| Sapling | Русский не заявлен | Да, до 2 000 знаков | Вероятность генерации и разбор по предложениям, есть API |
Обрати внимание на тройку zerogpt.com, zerogpt.net и zerogpt.org. Это три разных сайта трёх разных владельцев, которые эксплуатируют одно раскрученное имя. Результаты у них расходятся на одном и том же тексте, а два из трёх даже русский язык не заявляют. Когда тебе присылают «скрин из ZeroGPT», первым делом спроси, из какого именно.
Главная беда списка — язык. Больше половины сервисов обучались на английском, русский текст они оценивают по остаточному принципу: живой лонгрид со ссылками на ГОСТы может получить «80% ИИ», а машинный перевод английской генерации — пройти чистым. Для русских SEO-текстов гоняй материал через наш детектор ИИ-текста — он ищет признаки генерации, характерные именно для русскоязычных нейротекстов, и показывает, какие фразы вызвали подозрение.
Проценты точности из рекламы детекторов не цитирую сознательно: «98,5%» и «99%» на лендингах — маркетинг, замеренный на удобных выборках. Независимая проверка 14 детекторов (Weber-Wulff и соавторы) показала: точность падает ниже случайного угадывания, стоит прогнать сгенерированный текст через перефразирование или машинный перевод. Что подводит нас к следующему пункту.
Хуманизаторы: что они убирают и в чём подвох
Раз есть детекторы, есть и сервисы обхода — «хуманизаторы». Они переписывают сгенерированный текст так, чтобы статистические признаки генерации размылись: рвут однотипное построение абзацев, заменяют слова-маркеры, перемешивают длину предложений, выкидывают канцелярские связки.
Теперь подвох. Хуманизатор решает одну задачу — обмануть статистическую модель. Он трогает форму: синтаксис, порядок слов, частотность. Смысловые дыры при этом остаются на месте, а часто становятся глубже, потому что машинный перифраз ломает точные формулировки. Термин «коммерческий фактор» превращается в «торговый показатель», цифры съезжают, из связного абзаца получается набор предложений вразнобой.
Получается текст, который детектор пропустит, а читатель закроет на втором абзаце. Для SEO это проигрыш дважды: поведенческие метрики просядут, а Яндексу и Google, как мы разобрали выше, важна полезность текста, отметка «написано человеком» их не интересует.
Позиция практика простая. Детектор ловит форму, читатель чувствует пустоту. Хуманизатор маскирует первое и бессилен против второго. Полчаса ручной правки по схеме из предыдущего раздела — добавить свои цифры, убрать общие места, переписать выводы под свой опыт — бьёт любой сервис: текст перестаёт быть машинным по сути, и вопрос детекторов отпадает сам.
Что показал прогон по живым и сгенерированным текстам
Чтобы понимать, что показывает шкала, я прогнал через инструмент собственные материалы этого сайта — они написаны руками — и сгенерированные тексты. Прогон делался на одном и том же алгоритме, никакой подгонки под результат.
| Текст | Признаков | Разброс фраз | Конкретика |
|---|---|---|---|
| Сгенерированный текст про кофейни | 81% | 0,31 | 0% |
| Сгенерированный текст про SEO | 84% | 0,21 | 25% |
| Как собрать семантическое ядро | 11% | 0,71 | 51% |
| Почему SEO не конвертит | 8% | 0,53 | 30% |
| Накрутка поведенческих факторов | 4% | 0,55 | 48% |
| Политика конфиденциальности сайта | 2% | 1,23 | 74% |
Две вещи, которые видно из таблицы. Первая: разрыв идёт сразу по всем показателям — у генерации ровные фразы и пустая конкретика одновременно. Вторая, менее ожидаемая: самый «человеческий» результат показала политика конфиденциальности, документ сухой и формальный. Юридический язык неровный и набит конкретикой — датами, номерами, названиями. Формальность и машинность оказались разными вещами.
Что на самом деле думают Яндекс и Google про тексты нейросетей
Здесь много мифологии, поэтому по фактам.
Google сформулировал позицию в феврале 2023 года в документе о контенте, созданном ИИ: способ производства сам по себе не нарушает правила, значение имеет качество и польза. Нарушением остаётся массовая автогенерация ради манипуляции выдачей — это тот же спам, что и раньше, независимо от того, чем его произвели.
Яндекс отдельного публичного документа именно про нейросети не выпускал, но его правила про автоматически сгенерированные страницы существуют давно и работают ровно так же: под санкции идёт бессодержательный текст, сделанный ради объёма. Подробнее разбирал это в заметке про нейротексты и SEO — там же про то, почему у поисковика с собственной генеративной моделью есть свой интерес в этом вопросе.
Практический смысл такой. Никто не ищет в вашем тексте отпечатки GPT, чтобы наказать за сам факт. Наказывают за пустоту, а пустота у машинного текста просто встречается чаще, потому что генерация дёшева и её делают тоннами. Поэтому высокий процент признаков означает одно: текст ничего не сообщает читателю. Фильтр тут ни при чём.
Как править машинный черновик за пятнадцать минут
Машинный черновик — рабочий материал, если понимать, что именно в нём править. Порядок действий, который у меня занимает минут пятнадцать на статью.
- Выкинуть первый и последний абзац целиком. Вступление «в современном мире» и вывод «подводя итог» почти никогда не несут информации. Статья от их удаления только выигрывает.
- Заменить усилители цифрами. Каждое «значительно» и «существенно» — место, где нужен факт. Нет факта — предложение удаляется. Смягчать его бессмысленно.
- Разбить ритм. Найти три подряд идущих предложения одинаковой длины и переписать среднее — укоротить до реплики или срастить с соседним.
- Убрать связки в началах. «Однако», «кроме того», «таким образом» в первом слове абзаца вычёркиваются почти без потерь для смысла.
- Добавить то, чего у модели нет. Свой случай, цифру из своего проекта, возражение клиента, ошибку, которую сами допустили. Один абзац личного опыта делает для текста больше, чем вся остальная правка.
Если после правки хочется свериться, прогоните текст через проверку ещё раз, а следом через «Чистовик» — он ловит другое, воду и канцелярит, и эти два списка правок почти не пересекаются.
Частые вопросы
Как проверить текст на нейросеть онлайн бесплатно?
Можно ли проверить текст на плагиат и нейросеть одновременно?
Проверка на оригинальность и на нейросеть — это одно и то же?
Понижает ли Яндекс сайт за тексты от нейросети?
Какой процент считается нормальным?
Почему мой собственный текст показал высокий процент?
Можно ли обмануть проверку?
Главное
Машинный текст узнают по сочетанию: дежурные обороты, ровные предложения, отсутствие фактов. Ни один детектор не даёт доказательства авторства, и относиться к проценту стоит как к редакторской подсказке. Поиск при этом наказывает за пустоту. Поэтому правка машинного черновика сводится к простому: убрать штампы и добавить то, чего у модели нет, — свои цифры и свой опыт.
Прогнать текст можно прямо сейчас — проверка текста на нейросеть работает в браузере, бесплатно и без регистрации. Нужен разбор контента на сайте целиком — напишите мне.